
Capa a capa, o en una sola pista: cada voz debe estar presente
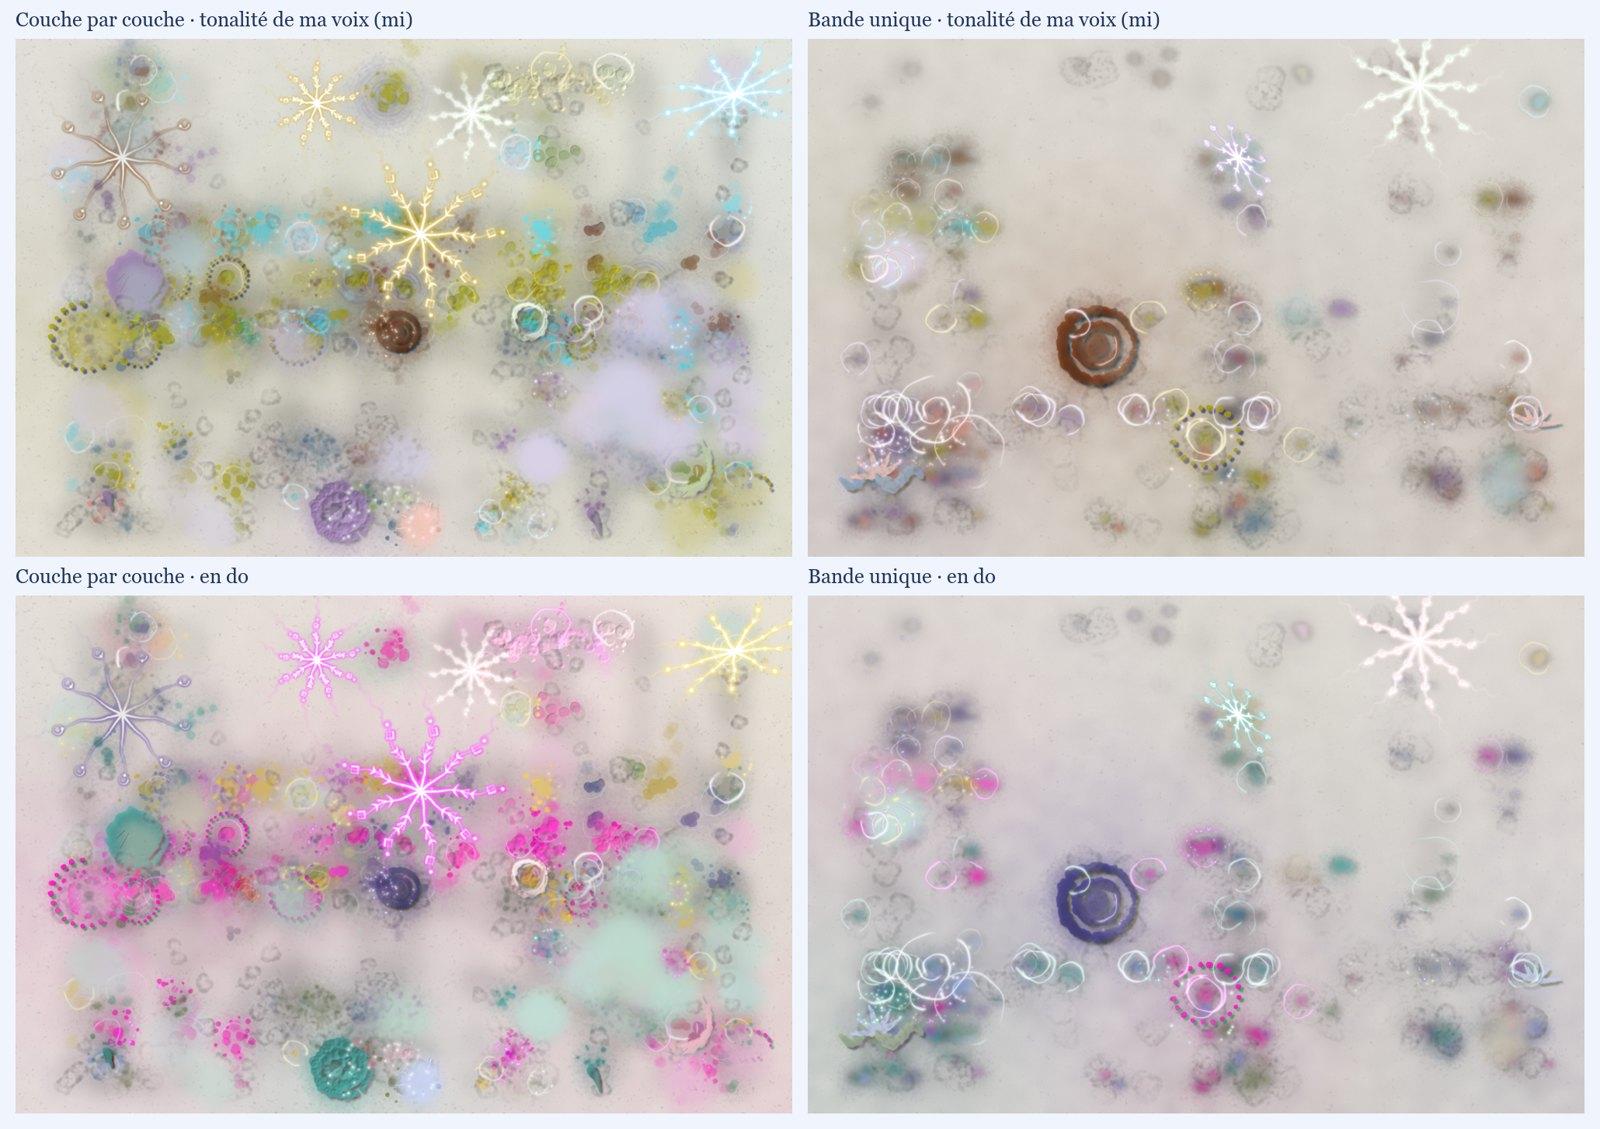
Mis tres voces pintan cada una su capa; ¿y si las fusionara en una sola franja antes de pintar? La pintura se disuelve entonces en un velo pálido: cuando las voces se funden, el tiempo, el espacio y el gesto de cada una se desvanecen.
Lo que he hecho
Mis obras sin datos cuentan con tres voces, y cada una pinta su capa: el lienzo conserva tres tiempos y tres gestos, que se superponen. He querido explorar el otro camino: reunir las tres voces en una sola pista de sonido y, a continuación, hacer que la herramienta la pinte. Lo hice primero con las tres lecciones de Concone del prototipo 22 («a», «o», «i»), y luego con el «Étude a».
Lo que he observado
En la pista única, la herramienta solo percibe el 47 % de las voces (entre el 82 % y el 85 % para cada voz por separado); el resto se convierte en ruido de fondo (52 %), y el silencio casi desaparece (1 %). Se pierde la altura: ante tres notas simultáneas, la herramienta percibe graves que no existen. La vocal que se oye se convierte sobre todo en «é» (39 %), una vocal que ninguna de las tres voces cantaba.
La pintura se disuelve en un velo pálido.
Lo que yo entiendo de ello
Cuando las voces se funden, el tiempo, el espacio y la acción de cada una se desvanecen: ya no dialogan, se mezclan. Capa a capa, cada voz existe; la única grabación es su fusión, y tiene la belleza de un velo, como la bruma sobre el agua. Mis obras conservan las capas. El velo podría convertirse en una cuarta capa: la fusión superpuesta a las tres voces.
Preguntas
Sombra y luz: ¿puede una misma obra mostrarse de ambas formas, capa a capa y como un velo?
¿Qué retiene el oído cuando el ojo ya no distingue las voces?
Referencias
Giuseppe Concone, 50 lecciones de canto, op. 9 (edición para voz aguda, Schirmer, IMSLP, dominio público).